flink · lac de données · traitement de flux
Le streaming devient le modèle de traitement par défaut du lac de données
Le lac a gagné la bataille du stockage, mais les pipelines restent majoritairement batch. Le traitement de flux n'est plus une niche: il devient la manière standard de transformer et servir les données.
Par Sabri Skhiri · · mis à jour le 24 septembre 2026
Le stockage s'est modernisé, pas le modèle de traitement
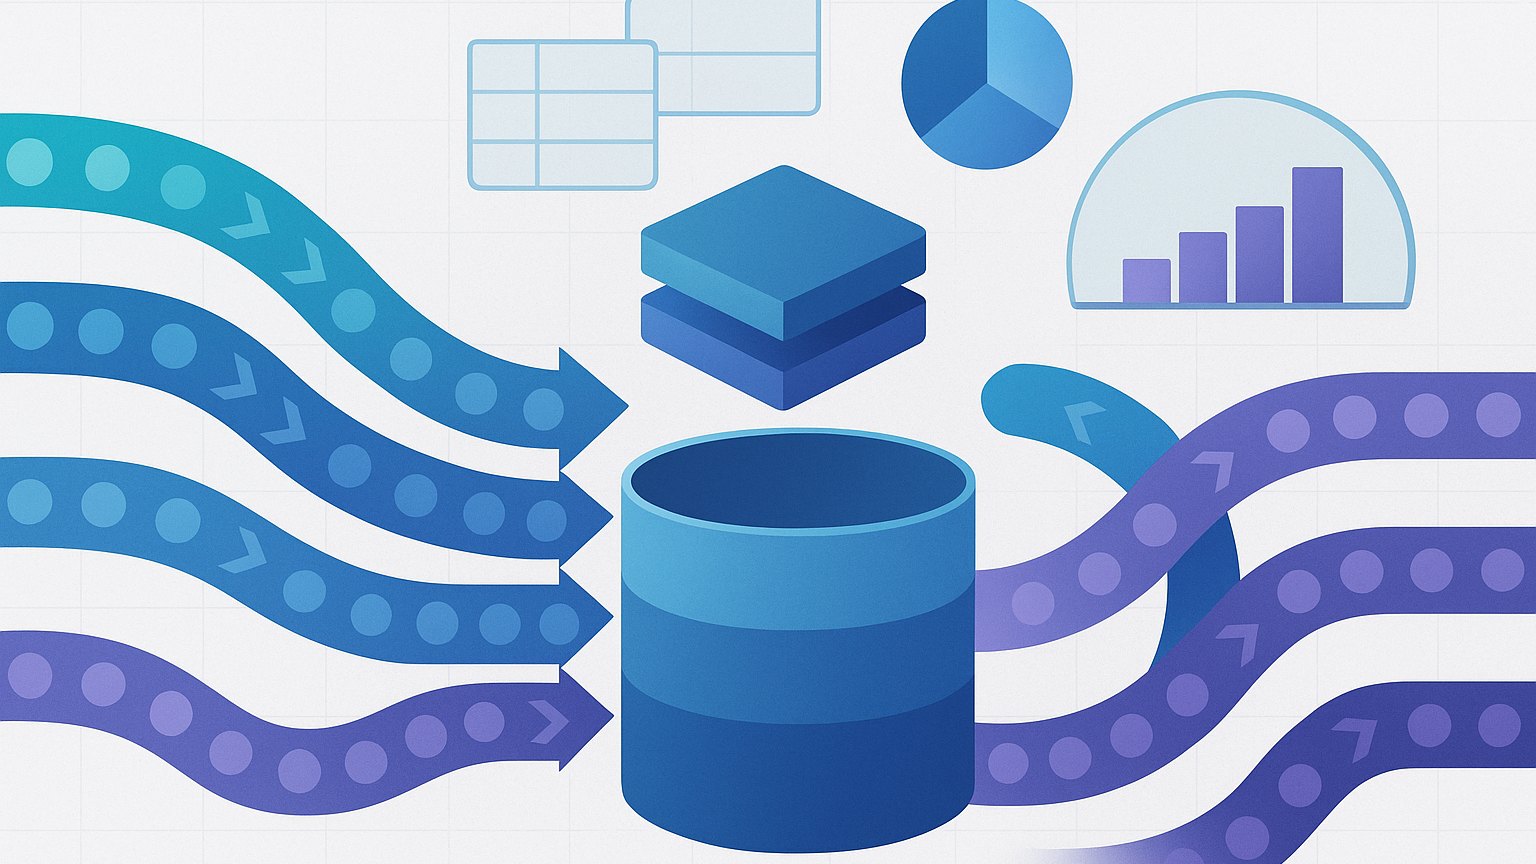
Le lac de données a gagné. Les formats ouverts ont tenu leur promesse: une copie unique, lisible par plusieurs moteurs, sans verrouillage de format. Mais la victoire a déplacé le problème. Les architectures medallion copient encore trois fois les mêmes données. La logique métier est écrite deux fois, pour l'opérationnel et l'analytique. La fraîcheur se dégrade à chaque couche.
Le traitement de flux consiste à ingérer et analyser les données à mesure qu'elles sont produites, en continu [1]. Cette approche n'est pas réservée à la détection de fraude ou aux capteurs. Elle devient le modèle de traitement par défaut: un flux est une table non bornée, une table est un flux matérialisé, et SQL peut exprimer les deux.
Trois signaux concrets
- L'état devient externalisé. Avec l'état désagrégé de Flink 2.0, la séparation calcul/stockage atteint enfin le streaming: l'état d'un job n'est plus limité par le disque local du worker.
- Les formats de table deviennent des sources et cibles de streaming crédibles. Les vecteurs de suppression et le lignage des lignes rendent une table de lac consommable de manière incrémentielle.
- Le verrouillage se déplace du format vers le catalogue. Une fois le format standardisé, la valeur monte d'une couche.
Enfin capable de réconcilier fraicheur et volumes des données sur les Data Lake modernes ! Les flux LakeFlow, par exemple, écrivent directement dans une table de streaming ou une vue matérialisée, y compris depuis plusieurs rubriques Kafka, sans refresh complet [2]. Le remplissage rétroactif reste possible en une exécution unique, et les requêtes UNION peuvent être remplacées par des flux d'ajout incrémentiels [2].
L'intégration avec dbt et la gouvernance
Exécuter dbt sur une plateforme ouverte évite la prolifération des outils et duplique moins de données. LakeFlow Pipelines en donne un bon exemple concret: il orchestre dbt de bout en bout, de l'ingestion des données brutes jusqu'aux modèles transformés, sans sortir du lac. C'est aussi une illustration d'intégration entre batch et streaming, car les tables de streaming et les vues matérialisées peuvent être alimentées par des flux incrémentiels, tandis que les transformations dbt s'exécutent sur ces mêmes tables. Les fondations ouvertes empêchent le verrouillage propriétaire, tandis qu'une orchestration et une gouvernance intégrées réduisent la charge opérationnelle [3]. C'est la même logique: la transformation s'exécute sur le lac, pas à côté.
Au-dessus de cela, une génération d'agents IA pilotés par événements se construit sur le moteur de streaming lui-même, plutôt que d'être greffée à côté. Le cours à Gand suivra ce fil, des fenêtres et de l'event time jusqu'à l'état de l'art industriel.